データの種類によって、AI の伸び方はどう違うのか?
複数分野でのスケーリング実験と、その違いを説明するための研究
シュナイダージヤン
GPU を 10 台、3か月使えるとしたら?
予測したい課題は決まっている。計算予算をどう使うか?
勘で決める
大きなモデルをいくつか作り
できるだけ学習させる
あとは結果を待つ
スケーリング法則を使う
小さく試して
本番の配分を予測する
予測が当たるかも確かめる
小さな実験から予測し、大きな実験で確かめる。
予算の配分を見直すと、小さいモデルが勝つこともある
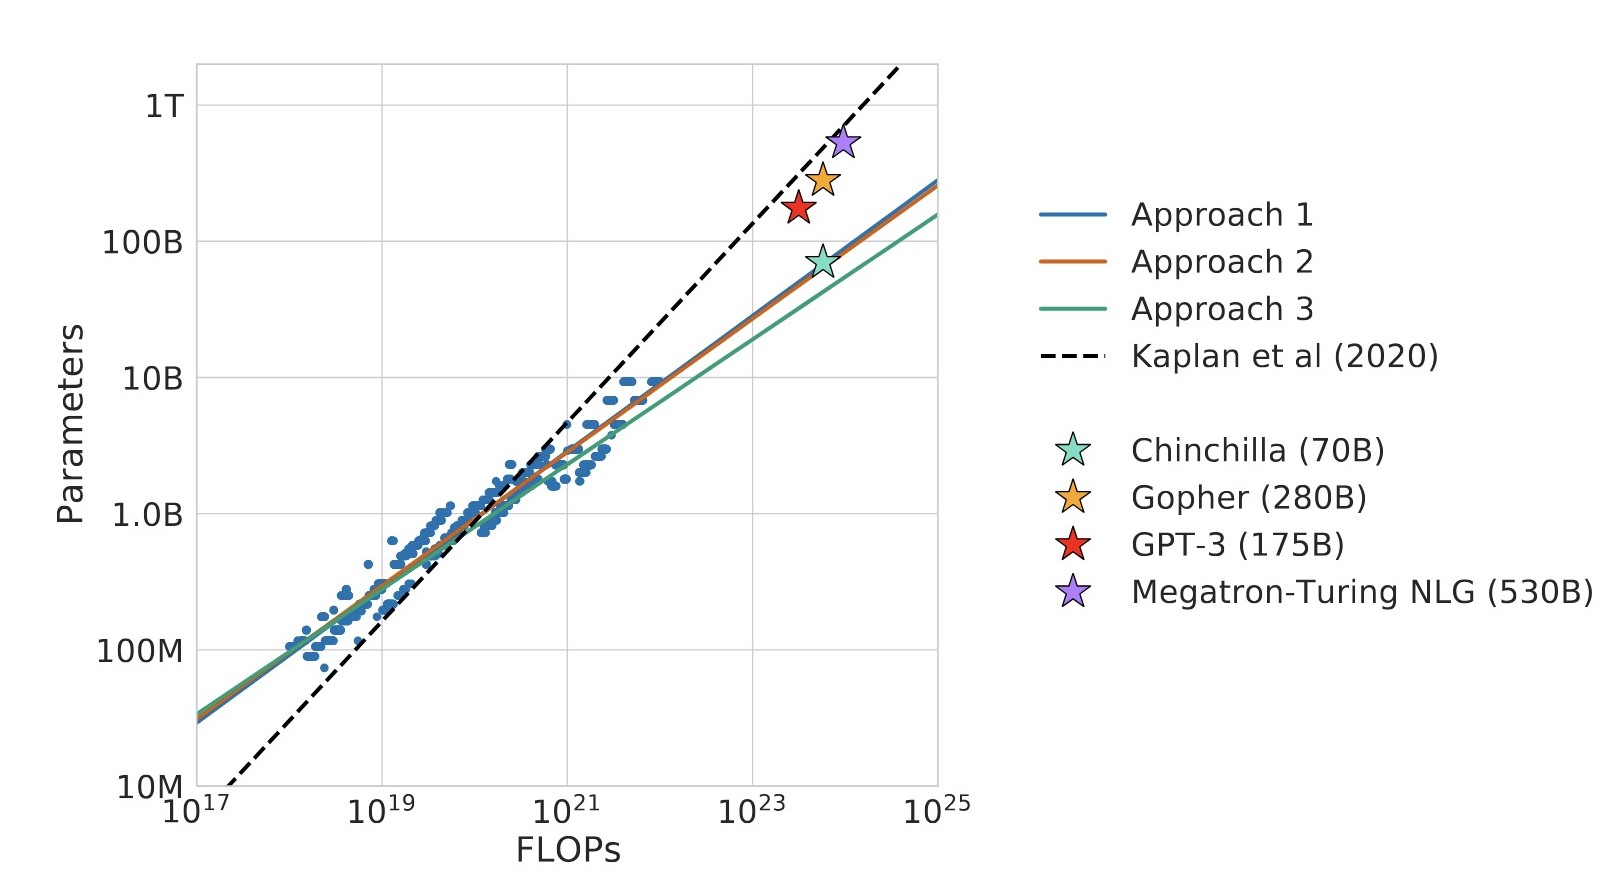
破線:Kaplan (2020) / 実線:Hoffmann (2022) の三つの推定方法
同程度の学習計算量で、小さい Chinchilla の方が高性能だった。
図:Hoffmann et al. (2022), Fig. 1。破線:Kaplan et al. (2020)。横軸=学習計算量、縦軸=パラメータ数(性能の図ではない)。
「増やせばよくなる」から「どれだけよくなるか」へ
損失=未学習のデータで測る、予測誤差の指標
L(D) = E + A D−β
説明用の概念図(実測値ではない)/ D:データ量、E:推定下限、β:改善の速さ
文章と音声では、計算量を増やしたときの伸び方が違う
■ LLM:文章の言語モデル ● SLM:音声の言語モデル
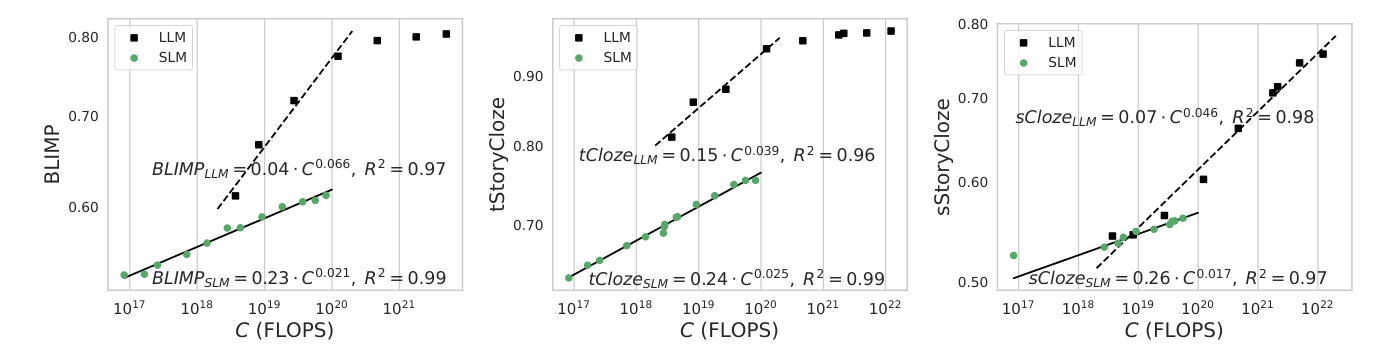
横軸:学習計算量 / 縦軸:正答率(高いほどよい)
この違いは、データの何から生まれるのか?
Cuervo & Marxer (2024), Figure 2(CC BY 4.0)。データ・トークン化・学習条件も異なる比較。
自分の研究:複数分野でモデルを学習し、伸び方を調べてきた
| 分野 |
取り組み・現在の状況 |
現時点の観察 |
| 音声 |
音声生成モデルの開発 |
本発表では結果の詳細を扱わない |
| エピゲノム |
Mamba2・GDN2・SH2 で実験 |
スケーリング則を観察。α・β が言語の参照値と異なる |
| 電子カルテ(EHR) |
実験を継続中 |
指数について予備的な傾向を観察 |
| 金融 |
限られた設定で試行 |
明確なスケーリング則はまだ得られていない |
同じように規模を増やしても、改善の仕方は一様ではない。
分野ごとにモデル・予測課題・学習条件が異なる段階での観察。
注目しているのは、当てはまりではなく「改善の速さ」
L(N, D) ≈ E + A N−α + B D−β
N:モデル規模 / D:学習データ量 / α・β:各項の減り方を表す指数
指数の違い
エピゲノムでは比較的大きく、
EHR ではそれより小さい傾向
(現時点の予備的な比較)
配分の違い
エピゲノムでは、言語の参照設定より
パラメータ増加に比重を置く配分を示唆
大きな指数 ≠ よい当てはまり(R²)
指数だけで分野の「難しさ」は決まらない。金融は指数の大小を比較できる段階ではない。
次の研究:何を変えると、伸び方が変わるのか?
| 切り分けたいこと |
次に検討している比較 |
| 実験・推定の問題か? |
学習設定、反復実験、測定する規模の範囲を確認 |
| データの量か、含まれる情報か? |
EHR で患者数と一人あたりの情報量を分ける |
| 時間による分布変化か? |
金融で評価する時期・時間的な距離による違いを調べる |
曲線の違いを観察する段階から、
条件を変えて理由を検証する段階へ。
まず EHR の実験を進め、既存のモデル・データを使って説明候補を絞る。
「どれだけ伸びるか」を予測し、「なぜ違うか」を理解したい
スケーリング法則の実用的な価値
小さく試し、
大きな投資の効果を予測する
私が研究で目指すこと
データの種類をまたいで、
学習のしやすさの違いを説明する
データと学習設定のどんな性質が、改善の速さを決めるのか?
これまで:複数分野での観察 / 次へ:条件を変えて説明候補を検証する。
補足:スケーリング法則の研究の広がり
| 研究の問い |
何を調べる? |
論文の例 |
| 予算をどう配分する? |
モデル規模と学習量 |
Hoffmann et al. (2022) |
| データが足りないときは? |
同じデータを反復する価値 |
Muennighoff et al. (2023) |
| なぜスケーリングが起きる? |
小課題へのニューロンの配分という仮説 |
Song et al. (2024) |
| データの種類が変わると? |
文章と音声の改善の違い |
Cuervo & Marxer (2024) |
補足:モデル規模と学習量を同時に考える
L(N, D) = E + A N−α + B D−β
N:パラメータ数 / D:処理した学習トークン数
C ≈ 6ND
密な Transformer の学習計算量の近似。系列長などの影響を省略。
固定した C の下で、L が小さくなる N と D を探す。
Hoffmann et al. (2022)。すべての研究がこの関数形・定義を使うわけではない。
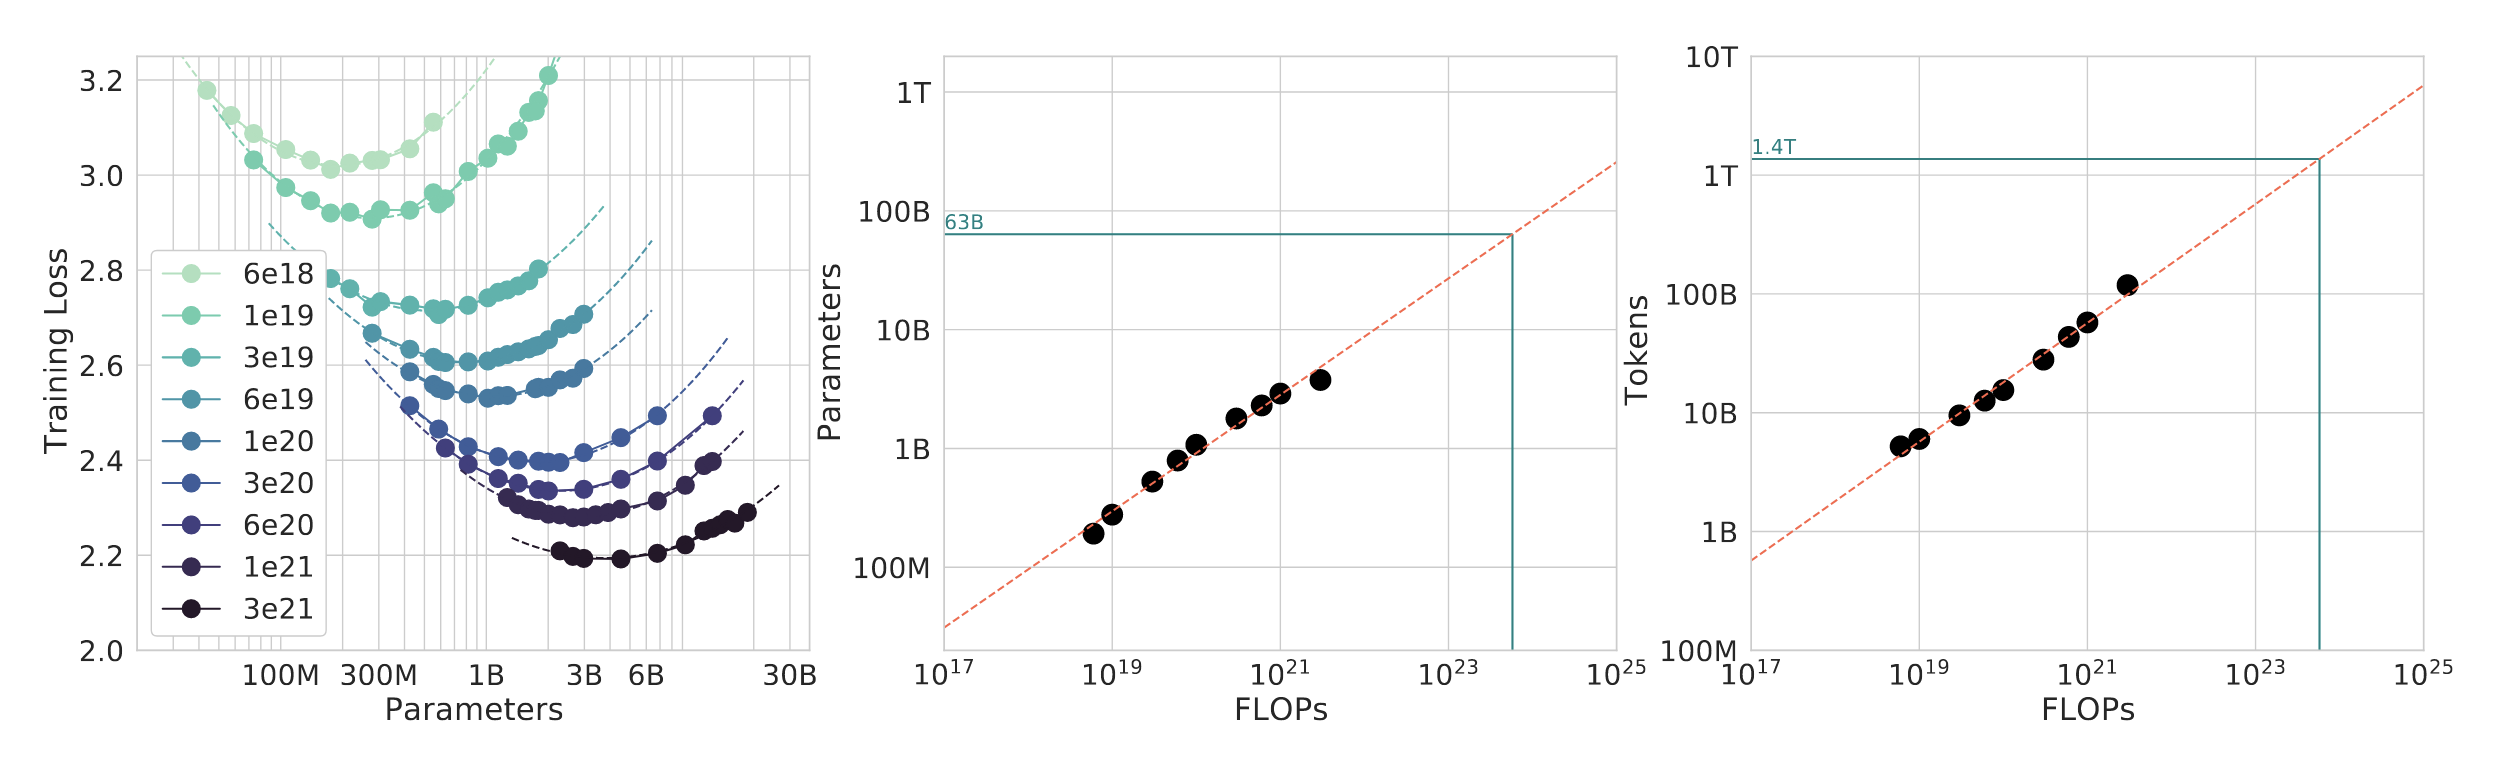
補足:同じ計算量で比べる(IsoFLOP)
同じ色の曲線=同じ計算予算。曲線の最小点が配分の候補。
Hoffmann et al. (2022)。昨年の発表で使った図。
補足:学習曲線の研究には長い歴史がある
| 年 |
位置づけ |
| 1992 |
Seung ・ Sompolinsky ・ Tishby:学習の統計力学 |
| 2017 |
Hestness ら:複数分野での経験的なスケーリング |
| 2020 |
Kaplan ら:言語モデルの規模と損失 |
| 2022 |
Hoffmann ら:計算予算の配分と Chinchilla |
(Seung et al., 1992; Hestness et al., 2017; Kaplan et al., 2020; Hoffmann et al., 2022)
補足:音声の結果は、評価課題と設定に依存する
- 文法・話題・物語の結末で、改善の速さは異なる
- 文章と音声では、データ・トークン化・学習条件も異なる
- 指数の比だけから、一定の計算量倍率は決まらない
Cuervo & Marxer (2024), Figure 2(CC BY 4.0)。
補足:下限が高いのか、改善が遅いのか?
- 狭い規模の範囲では、どちらも似た曲線に見える
- 広い規模、反復実験、推定の不確実性、別の関数形で確認する
- 同じ予測対象で、入力情報への介入を比較する
- 頭打ちだけでは、不可約誤差・容量不足・学習不足を区別できない